会写提示词,只是第一步。
真正决定企业 AI 能不能进入业务的,是它回答前到底看到了什么。
◷ 2026-09-20 ▣ 来源:贯文智能体◉ 阅读
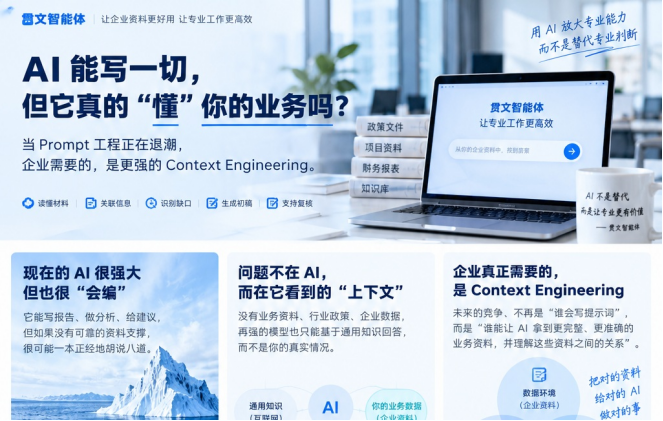
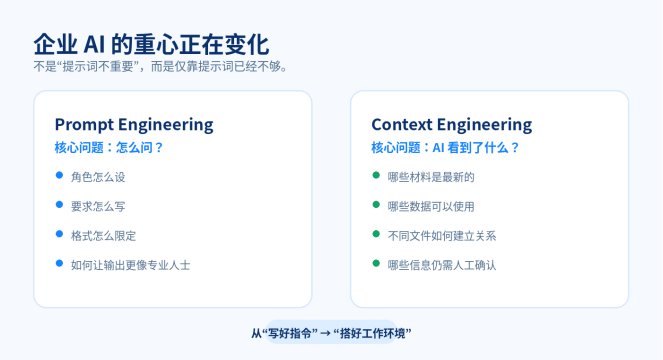
一句话理解:Prompt Engineering 解决“怎么问”;Context Engineering 解决“AI 在回答前,应该看到哪些材料、规则、数据和历史记录”。
过去两年,企业使用AI,最先卷的是 Prompt
角色怎么设?格式怎么写?如何让输出更专业?
这些当然有用。
但当AI 真正进入报告、资料分析、政策问答、项目复盘之后,问题很快变了:不是“它会不会写”,而是“它到底依据什么写”。
01 企业AI的瓶颈,正在从“不会问”变成没有上下文
你让 AI 写一份企业研发能力分析。
它并不缺写作能力。
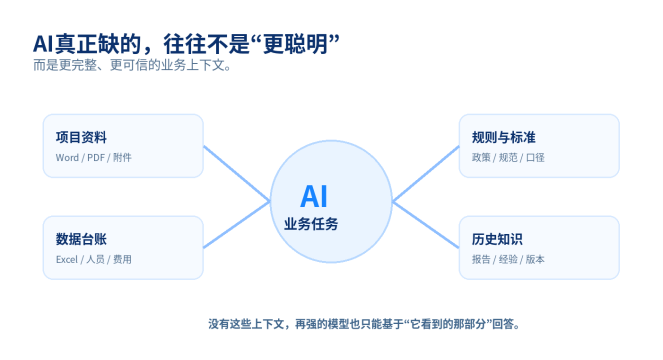
它真正缺的是:哪份人员名单最新?研发费用用哪个口径?去年报告里的结论还有效吗?某个数字来自 Excel,还是聊天记录里的补充?
如果这些信息没有被组织起来,AI 只能基于“它看到的那一部分”继续生成。
最麻烦的不是 AI 写得差,而是它写得太顺——看起来像对的,实际经不起复核。
02 Context Engineering 到底是什么?
可以把它理解成:AI 开始工作之前,先把“工作现场”搭好。
哪些文件该看。
哪些数据可信。
哪些规则必须遵守。
哪些历史信息已经过期。
哪些地方还需要人确认。
Prompt 更像在优化“命令”;Context 更像在建设“工作环境”。
03 这也是贯文智能体更重视“材料—关联—复核”的原因
贯文智能体不是一上来就让 AI 写。
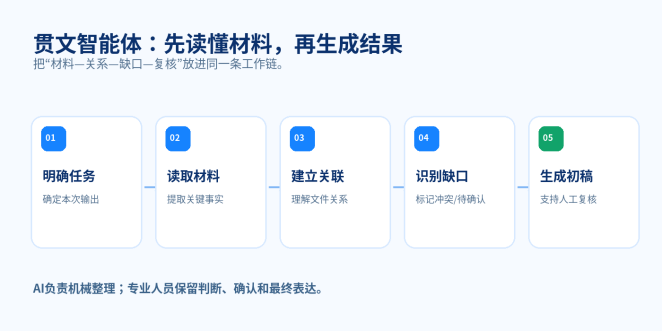
先明确任务,再读取材料。
系统提取主体、时间、人员、费用、成果等关键信息,并把相关文件建立关联。
如果遇到版本冲突、口径差异、附件缺失,不直接写死,而是保留待确认项。
确认核心信息后,再生成初稿,最后交给专业人员复核。
04 企业真正需要的,不是“更会聊天”的 AI
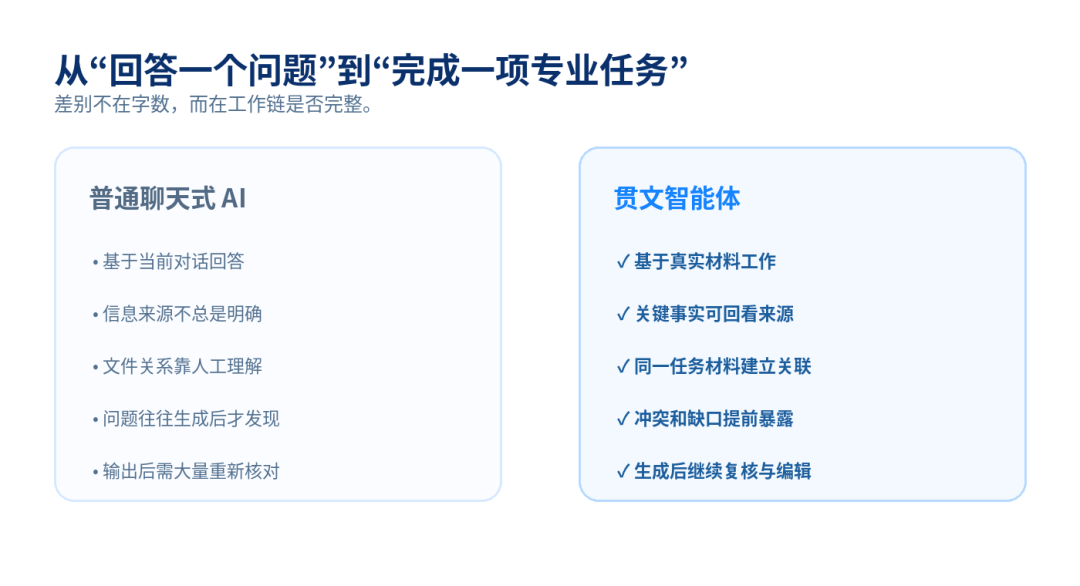
企业需要的是一个能参与任务的 AI。
能使用真实材料。
能理解资料之间的关系。
能把不确定性暴露出来。
能让结果回到来源。
能把生成、核对和修改放进同一条工作链。
05 真正值得沉淀的,是企业自己的“上下文资产”PART FIVE
Q1
提示词可以复制。模型也会持续升级。
真正难复制的,是一家企业长期积累的材料结构、知识口径、任务标准和复核规则。
当这些内容能够持续被 AI 调用,AI 才不再只是一个临时工具。
它会开始变成团队知识和工作流程的一部分。
未来企业之间的 AI 差距,可能不只是“用了哪个模型”,而是谁能让 AI 在更完整、更可信、更有组织的上下文里工作。
06 最后
AI 的下一阶段,未必是谁的 Prompt 写得更复杂。
更可能是谁能让 AI 真正读懂自己的业务。
贯文智能体正在做的,就是把分散资料、关键关系、问题提示和人工复核,放到一个更完整的工作流程里。
让 AI 不只是“会回答”,而是开始真正参与专业工作。
贯文智能体
贯文智能体将持续关注企业最新政策、行业动态,帮助企业及时掌握变化。